
读懂 Skills:是什么、怎么写、为什么有效
Skills 是个啥?
自从 Claude 带火了 MCP 后,最近又带火了一个新的词:Skills。
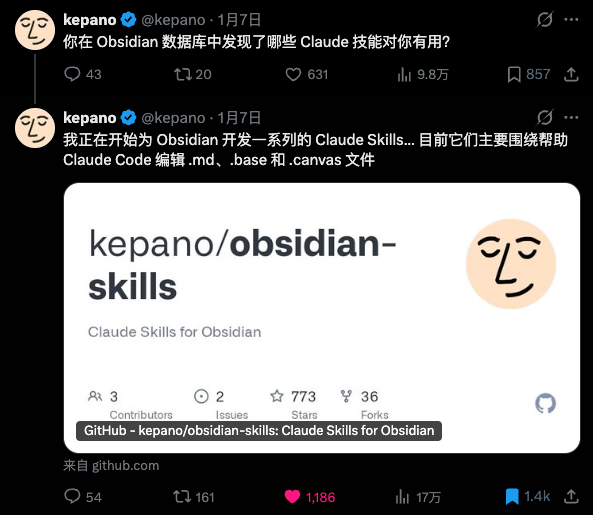
各种 GitHub 上被疯狂 star 的仓库,很多也都是 Skills 相关。比如下面这个仓库,整理了很多非常实用的 Skills。
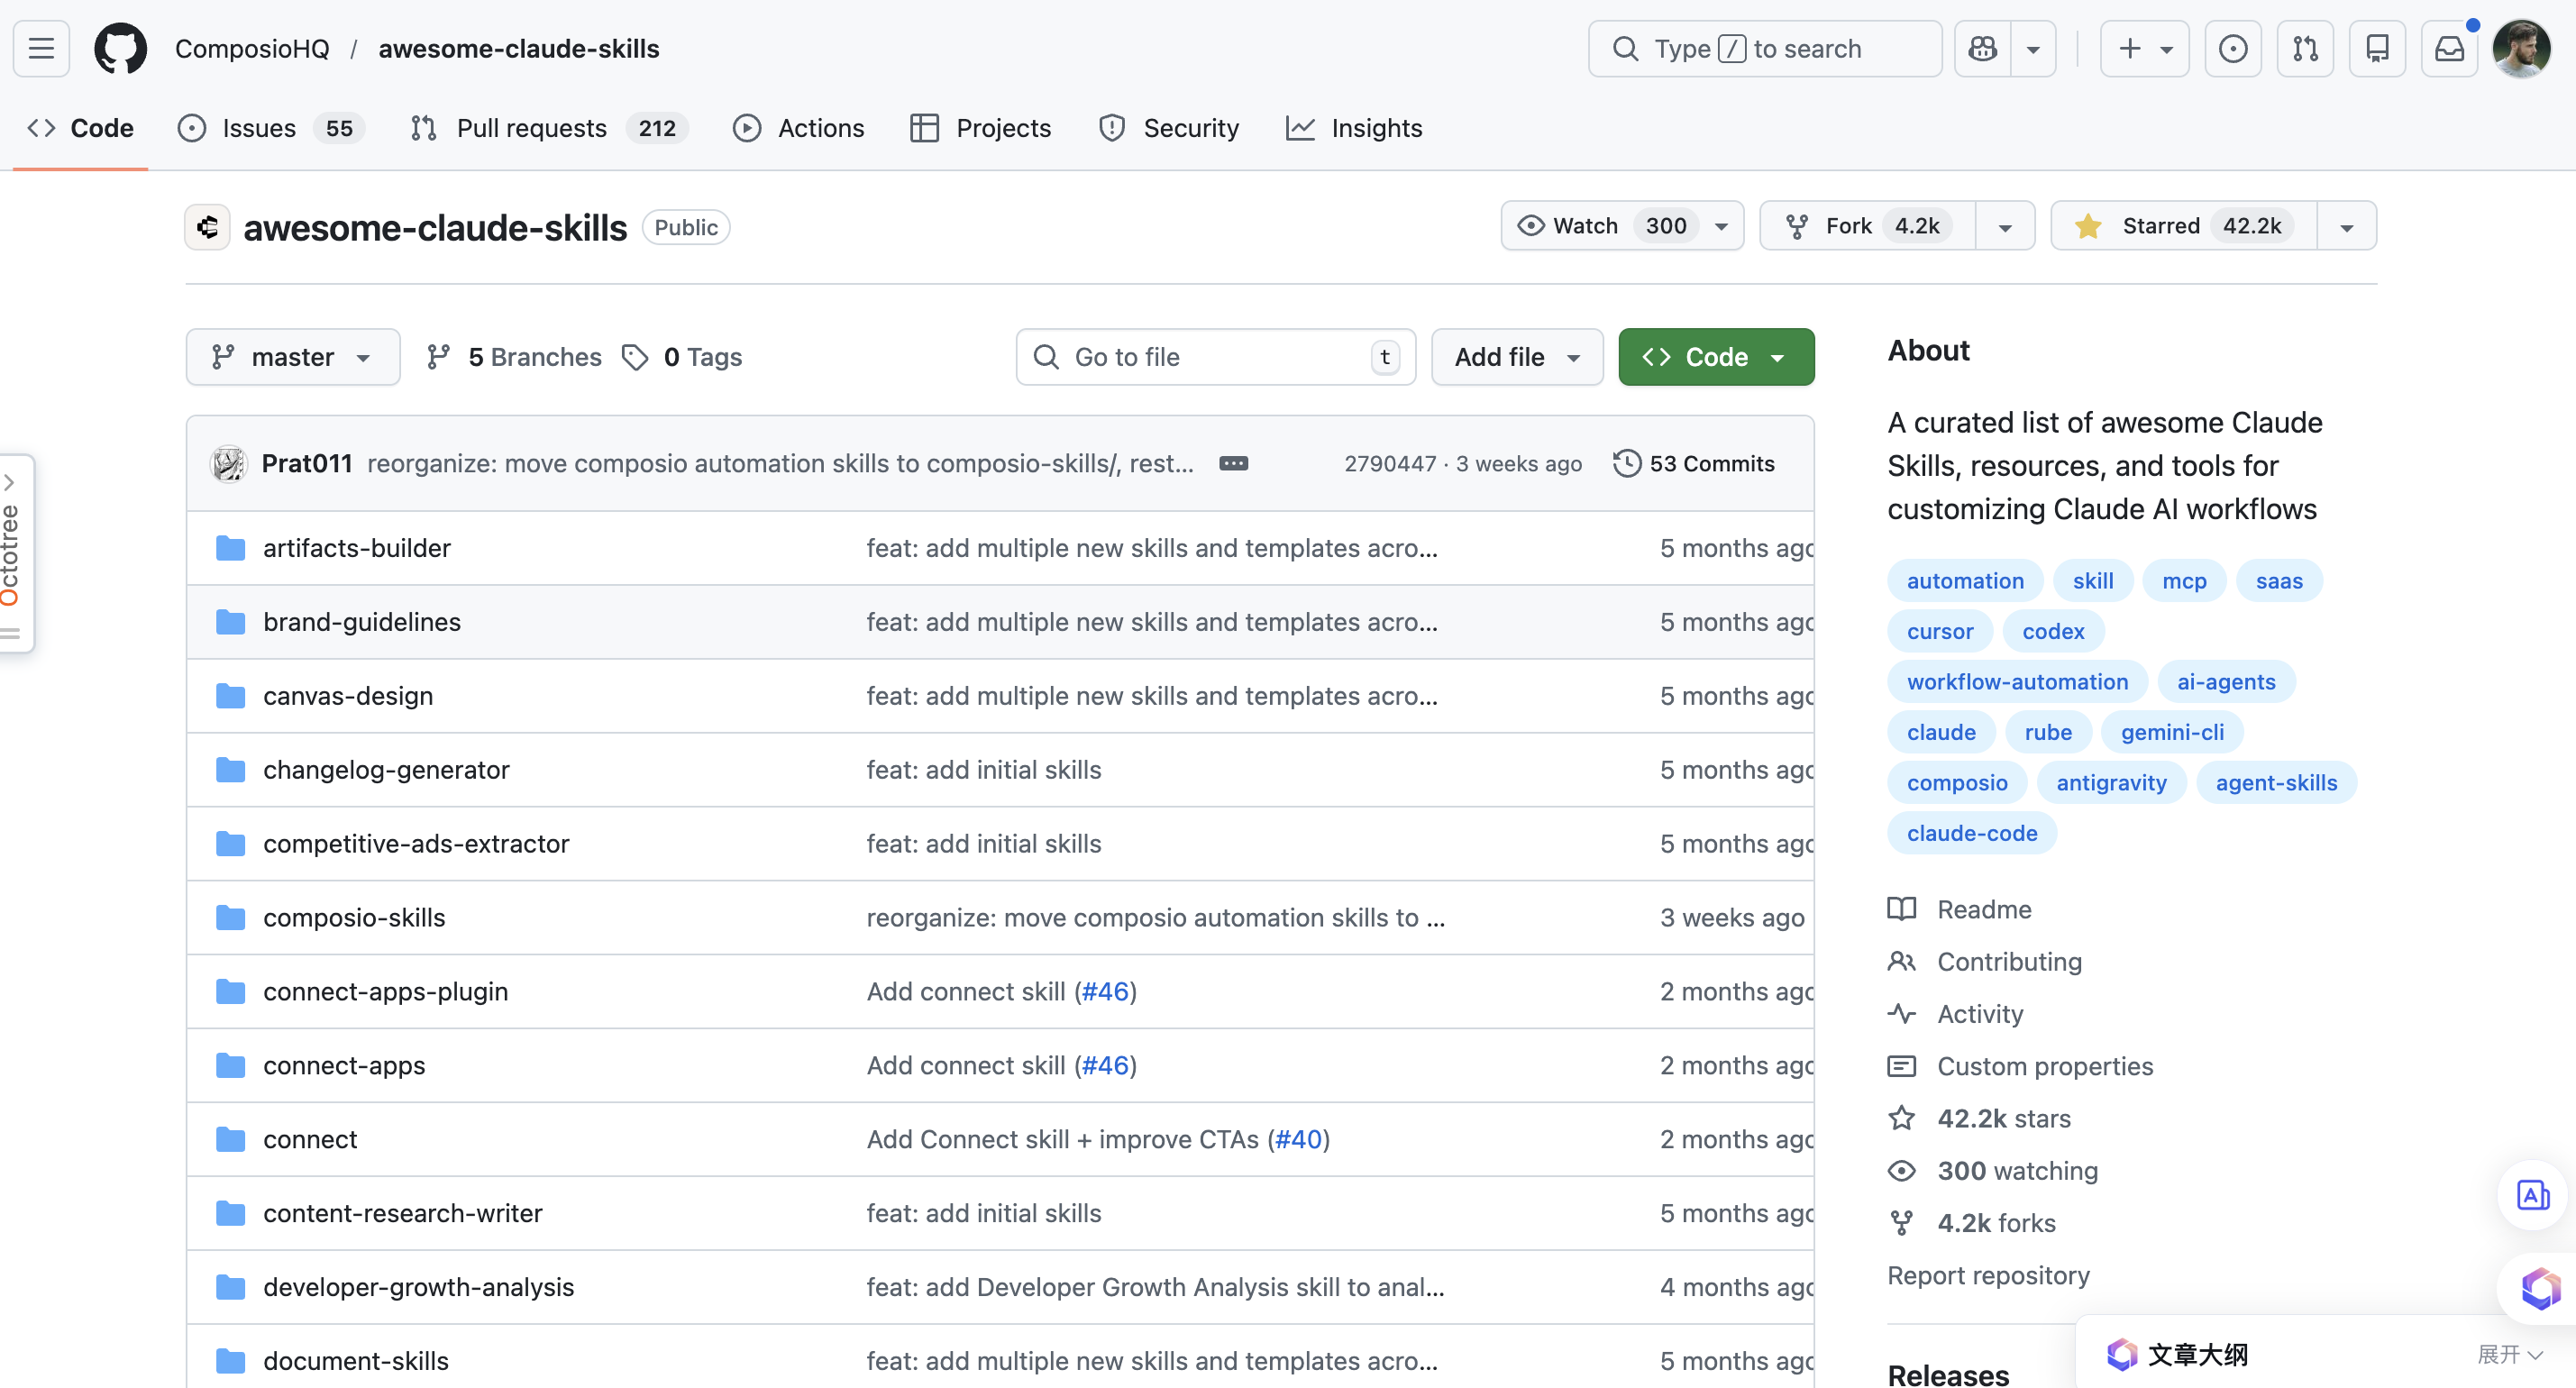
Anthropic 官方也公布了一组他们自己制作的 skills。
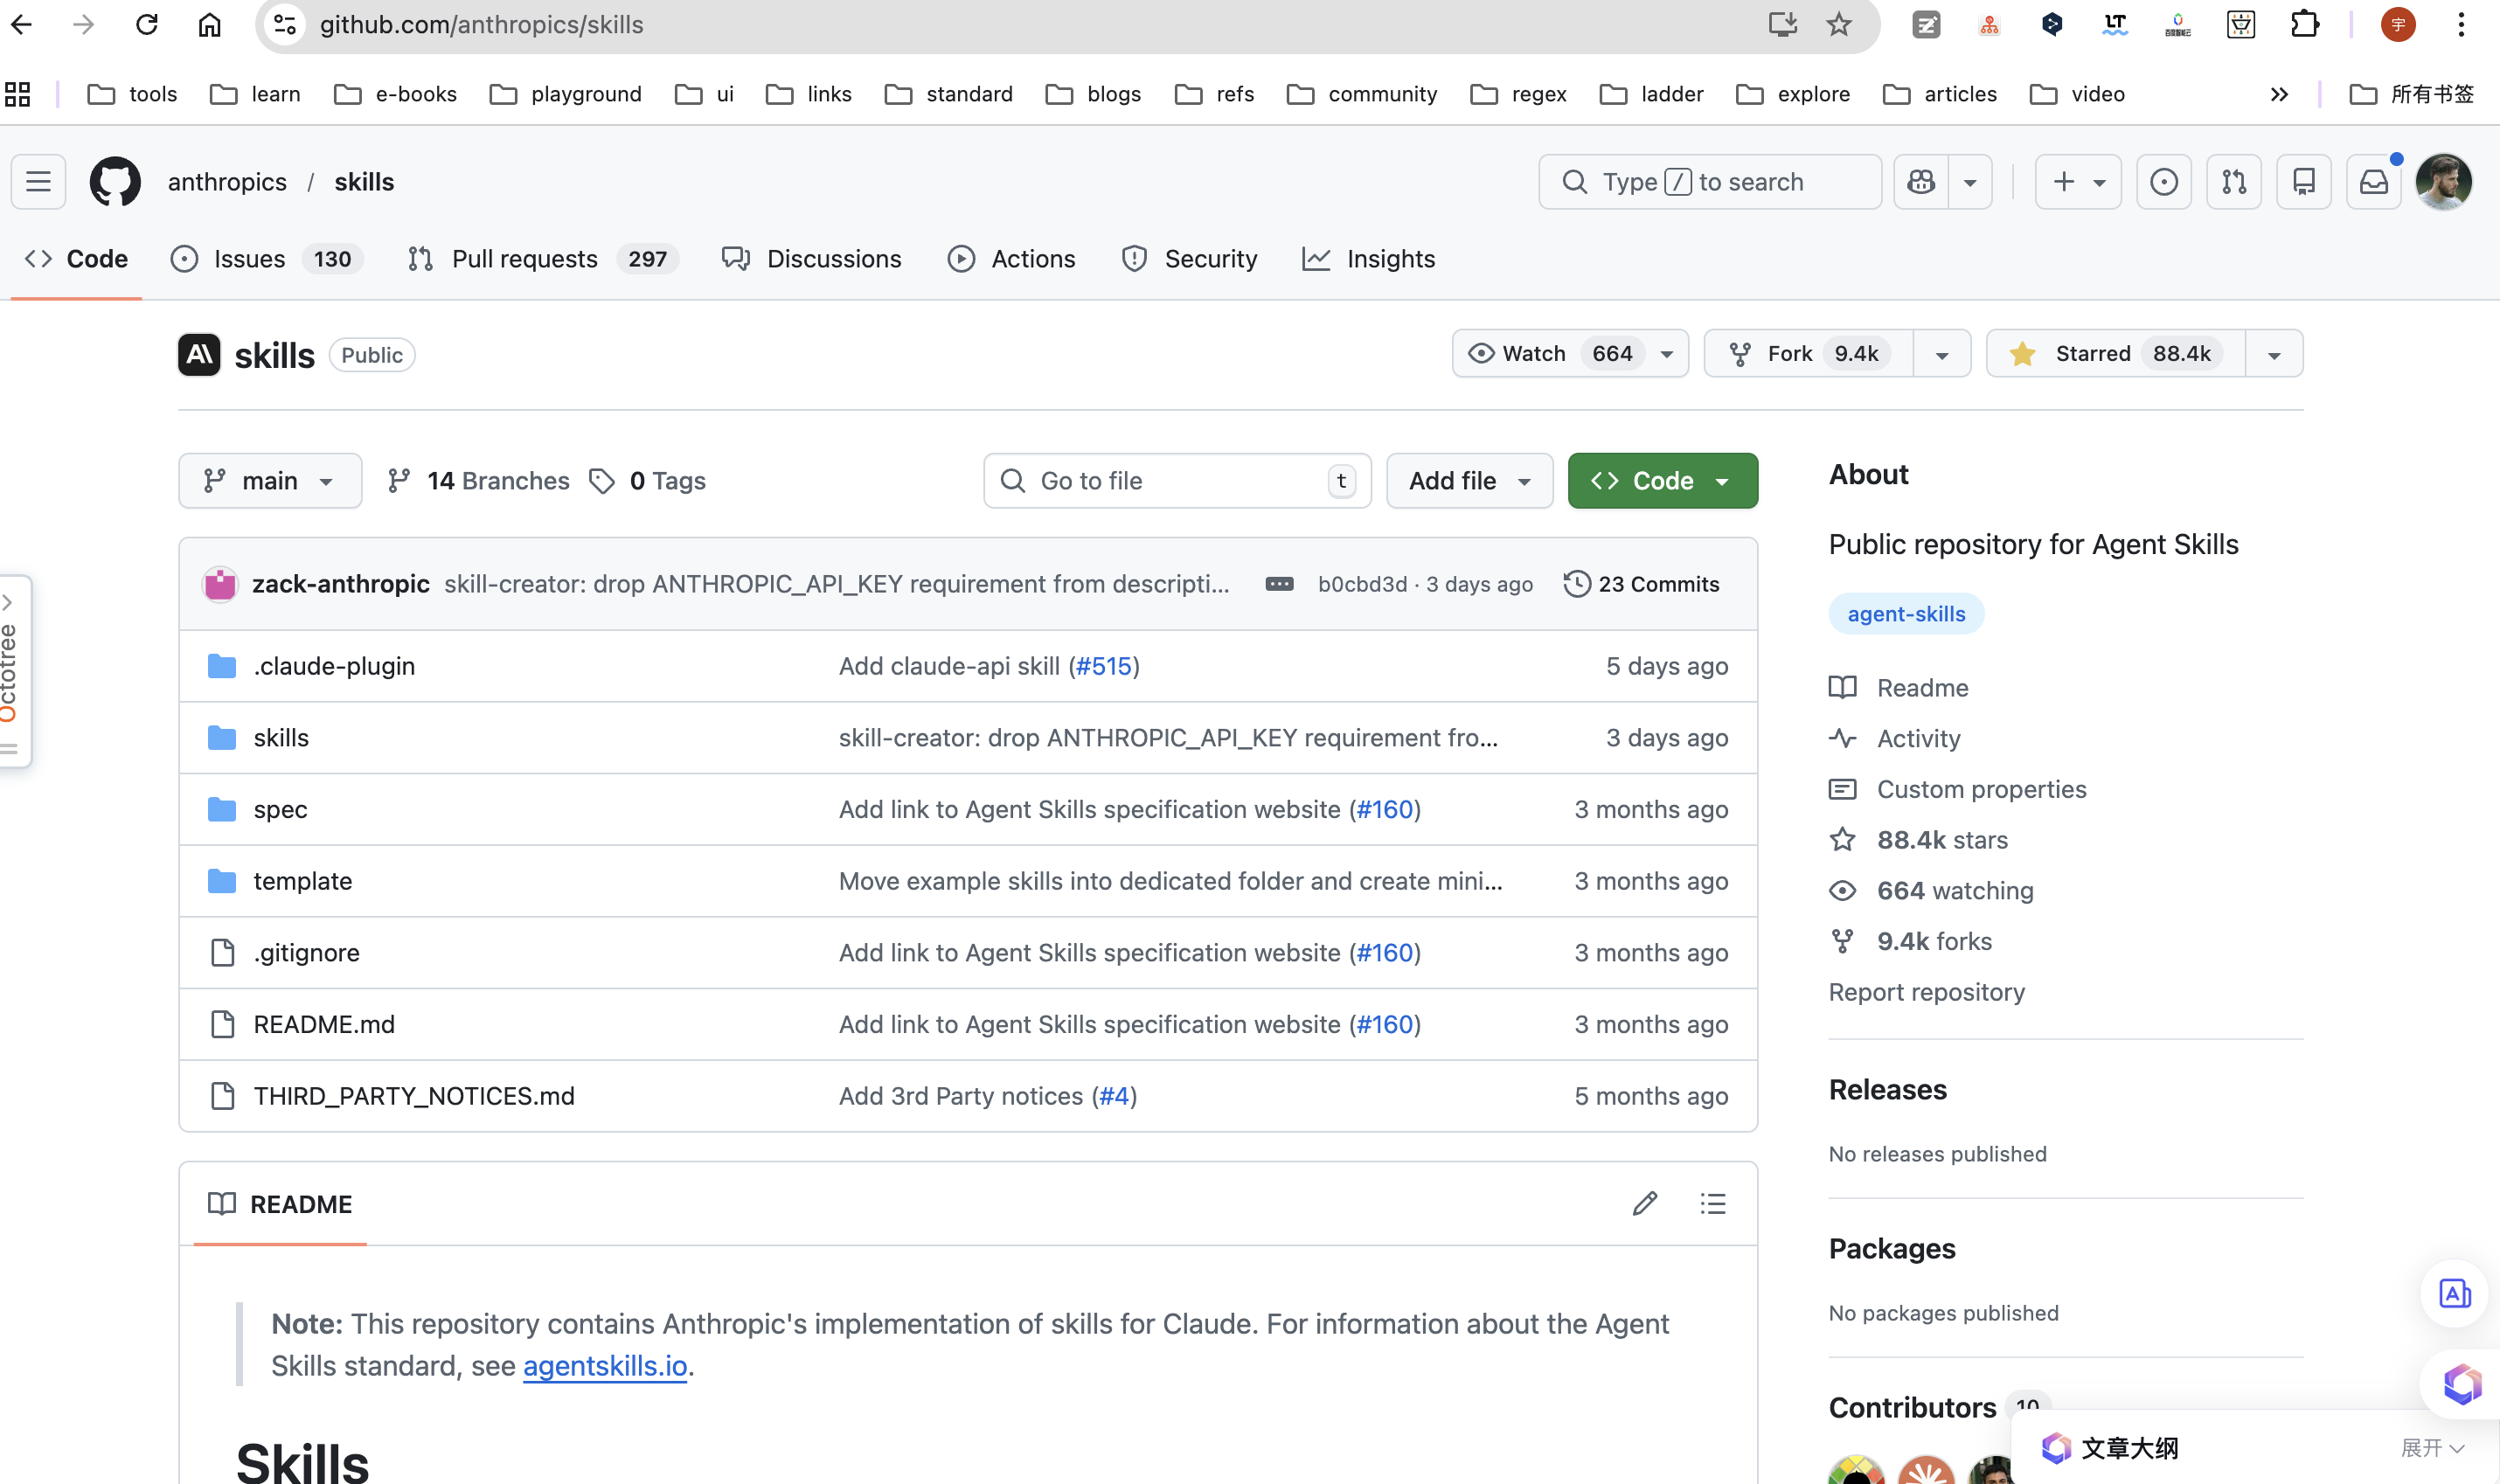
里面包含的 skills 有如下这些,都是非常实用的技能。
Skills,翻译过来就是技能,字面意思上非常简单,给 Agent 用的技能。
Skills 是把可执行能力显式化,让 Agent 在需要时调用。调用的过程类似于 webpack 里边的 plugin,比如具体执行代码压缩混淆、给 html 注入一些变量等。
Skills 和 Rules、MCP、Prompt、Agent 的区别
下面是我个人的理解:
Rules:控制能力,比如什么时候调用工具,回答格式,回答顺序,安全策略等。
Skills:做事能力,比如搜索、计算、写代码、发邮件等具体的能力。
MCP:连接能力,比如连接 GitHub、数据库、IM 软件、本地文件等。
Prompts:驱动能力,比如一步一步地提示 Agent 完成一件事,需要多轮对话才能完成,类似于命令式编程。
Agent = 使用 Prompts + Rules + Skills + MCP 的 AI 执行者,也就是各种 AI 助手,大模型通过 Agent 完成实际工作。
针对 JavaScript 有一句名言,即一切能被 JavaScript 重写的地方都将被重写。对于 Skills 也是一样的,一切能够被 Skill 化的能力都将被 Skill 化。
Skills 应用场景
一、文档处理类
这是最成熟的一类,Anthropic 自己就内置了这几个官方 skill:
- PPT 生成与编辑 — 根据大纲自动做幻灯片,套模板、调布局
- Word 文档 — 生成报告、合同、备忘录
- PDF 处理 — 提取文字、填写表单、合并拆分
- Excel/表格 — 数据分析、生成图表、批量处理数据
二、代码开发类
- 项目规范落地 — 将团队的 API 命名规范、文件结构、提交信息格式等编码进 skill,Claude 自动遵守,不用每次重复说
- 框架特定工作流 — 比如你们用的是特定版本的内部框架,把用法写进 skill,Claude 就不会给你生成错误的 API
- 部署流程 — 把测试 → 构建 → 推送的步骤封装成一个
/deployskill,手动触发,避免自动误触
三、内容创作类
- 品牌语气规范 — 把公司的文案风格、禁用词、措辞偏好写进 skill,生成的内容自动符合品牌调性
- 行业报告模板 — 把特定格式的报告结构固化,每次生成结构一致
- 多语言本地化 — 封装翻译偏好和用词表,输出符合本地习惯的内容
四、数据与研究类
- 竞品监控 — 定时抓取信息、按固定格式整理摘要
- 财报分析 — 封装财务分析的思路和输出格式,输入 10-K 自动产出结构化报告
- 代码库问答 — 把内部系统的架构文档、数据模型放进 skill,Claude 回答内部技术问题时有准确的上下文
五、流程自动化类(结合 Agent 框架)
- 邮件/消息处理 — 自动分类、汇总、起草回复
- 日历管理 — 自动识别会议请求、安排日程
- 数据采集流水线 — 定时抓取、清洗、入库
- 多 Agent 协作 — 一个 skill 负责搜索、一个负责分析、一个负责生成报告,拆分工作流
六、组织/团队管理类
- Onboarding 知识库 — 把新人需要了解的项目背景、规范全封装进 skill,新成员直接用
- Sprint 规划 — 把团队的迭代流程写进 skill,Claude 按固定步骤辅助 planning
- 安全合规检查 — 把合规要求写进 skill,Claude 在生成内容或代码时自动核查
判断什么时候值得写成 skill
一个简单的经验法则:重复 5 次以上、未来还会再用 10 次以上,就值得封装成 skill。
如果只是偶尔一次性的任务,直接在对话里给上下文就够了;如果是你或团队会反复做的事情,写成 skill 之后就再也不用重复提供背景信息了。
Skills 格式规范
Skills 更像一个知识库般的文件夹,里面可以放规范、脚本、模板、参考资料等等。
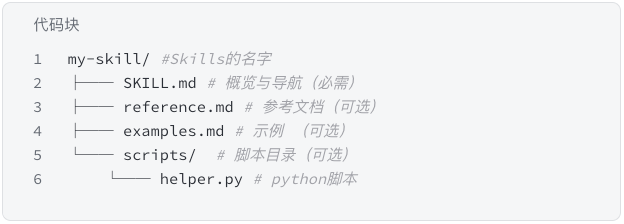
这个是官方的实例结构,同时对 Skill 也有很多必须要求。
官方明确要求:SKILL.md body 应控制在 500 行以内,超出部分应拆分到 references/ 目录中。如果文件内容严重超标,会挤占推理空间、降低性能。
官方要求 description 必须用第三人称,因为它会被注入到 system prompt 中。
官方要求 name 必须是 kebab-case(小写字母 + 连字符),且应与文件夹名一致。
官方核心设计原则是三级渐进披露:
- 第一级(YAML frontmatter):始终加载,仅用于判断是否触发
- 第二级(
SKILL.mdbody):触发后加载,包含核心指令 - 第三级(Linked files):按需加载,详细参考资料
1. Front Matter(必须)
文件开头是 YAML front matter,包含三个字段:
---
name: pptx
description: "详细描述何时触发此技能。包括触发关键词、适用场景、
             以及明确说明不适用的情况(Do NOT use for...)"
license: Proprietary. LICENSE.txt has complete terms
---
description 是最关键的字段,它直接决定 Claude 会不会在正确的时机调用这个技能,所以要写得非常详细,覆盖所有触发词和场景边界,并且一定要用第三人称,因为描述会被注入到 system prompts 里。
2. 文件主体结构
# 技能标题

## Overview(可选)
简短说明该技能处理的对象是什么

## Quick Reference(推荐)
用表格列出常见任务 → 对应方法/子文档

## 具体操作章节
每个主要工作流一个 ## 章节,附带代码示例

## QA / 验证步骤(推荐)
如何检查输出质量

## Dependencies(推荐)
列出所有需要安装的工具
3. Quick Reference 表(核心约定)
几乎所有技能都有这张表,作为 Claude 的决策入口:
## Quick Reference

| Task         | Guide                        |
|--------------|------------------------------|
| 读取内容      | `python -m markitdown file`  |
| 编辑模板      | Read [editing.md](editing.md)|
| 从头创建      | Read [pptxgenjs.md](pptxgenjs.md) |
表格把复杂任务分流到对应的 reference .md 文件,保持主文件简洁。
4. 目录结构约定
skills/
└── my-skill/
    ├── SKILL.md          ← 入口,必须
    ├── LICENSE.txt       ← 必须
    ├── editing.md        ← 按需,专项参考文档
    ├── reference.md      ← 按需
    └── scripts/
        ├── __init__.py
        ├── tool_a.py
        └── office/       ← 可嵌套子目录
5. 写作原则
| 原则 | 说明 |
|---|---|
| description 要穷举触发词 | 关键词、同义词、文件扩展名都要列出 |
| 主文件保持简短 | 细节放到 reference .md,SKILL.md 只做导航 |
| 代码示例要可直接执行 | 命令应能直接复制进 bash_tool 运行 |
| 包含 QA 步骤 | 说明如何验证输出是否正确 |
| 列出所有依赖 | pip install / npm install 等,让 Claude 知道先装什么 |
| 明确排除边界 | Do NOT use for... 防止误触发 |
Skills 工作原理
LLM 的通用能力可以非常强大,但是面对一些领域问题可能就发挥不佳,而 Skills 正是为了弥补这部分领域能力而出现的。除了 SKILL.md 会被传递给大模型,Skill 的其它资源会被模型通过 tools 里的工具读取(view)或执行(Bash)。正所谓数据不动代码动,代码和资源并不会自动被传递给 LLM,通过 View、Bash 等工具阅读文件或执行脚本的结果会被传递给 LLM。
渐进式披露
这里有个特别关键的设计,叫 progressive disclosure,中文名叫渐进式披露,在过去移动互联网时代,可以说是我们做用户体验设计时的最高法则之一,我们每天用的菜单栏,就是渐进式披露的最常见的设计。
这是因为人的瞬时记忆区比较小,一般是 7±2 个信息块,而 AI 因为受限于 Token,其实在本质上,是一模一样的。
所以 Skills 的工作原理,就和这个类似。先放目录,再放章节,最后放附录。先让模型加载一小段 Skill 的元信息,让模型知道有这么个 SOP 手册,当它判断用得上的时候,会先读取完整的 SKILL.md 文件,然后 references 或者 assets,调用脚本执行任务。
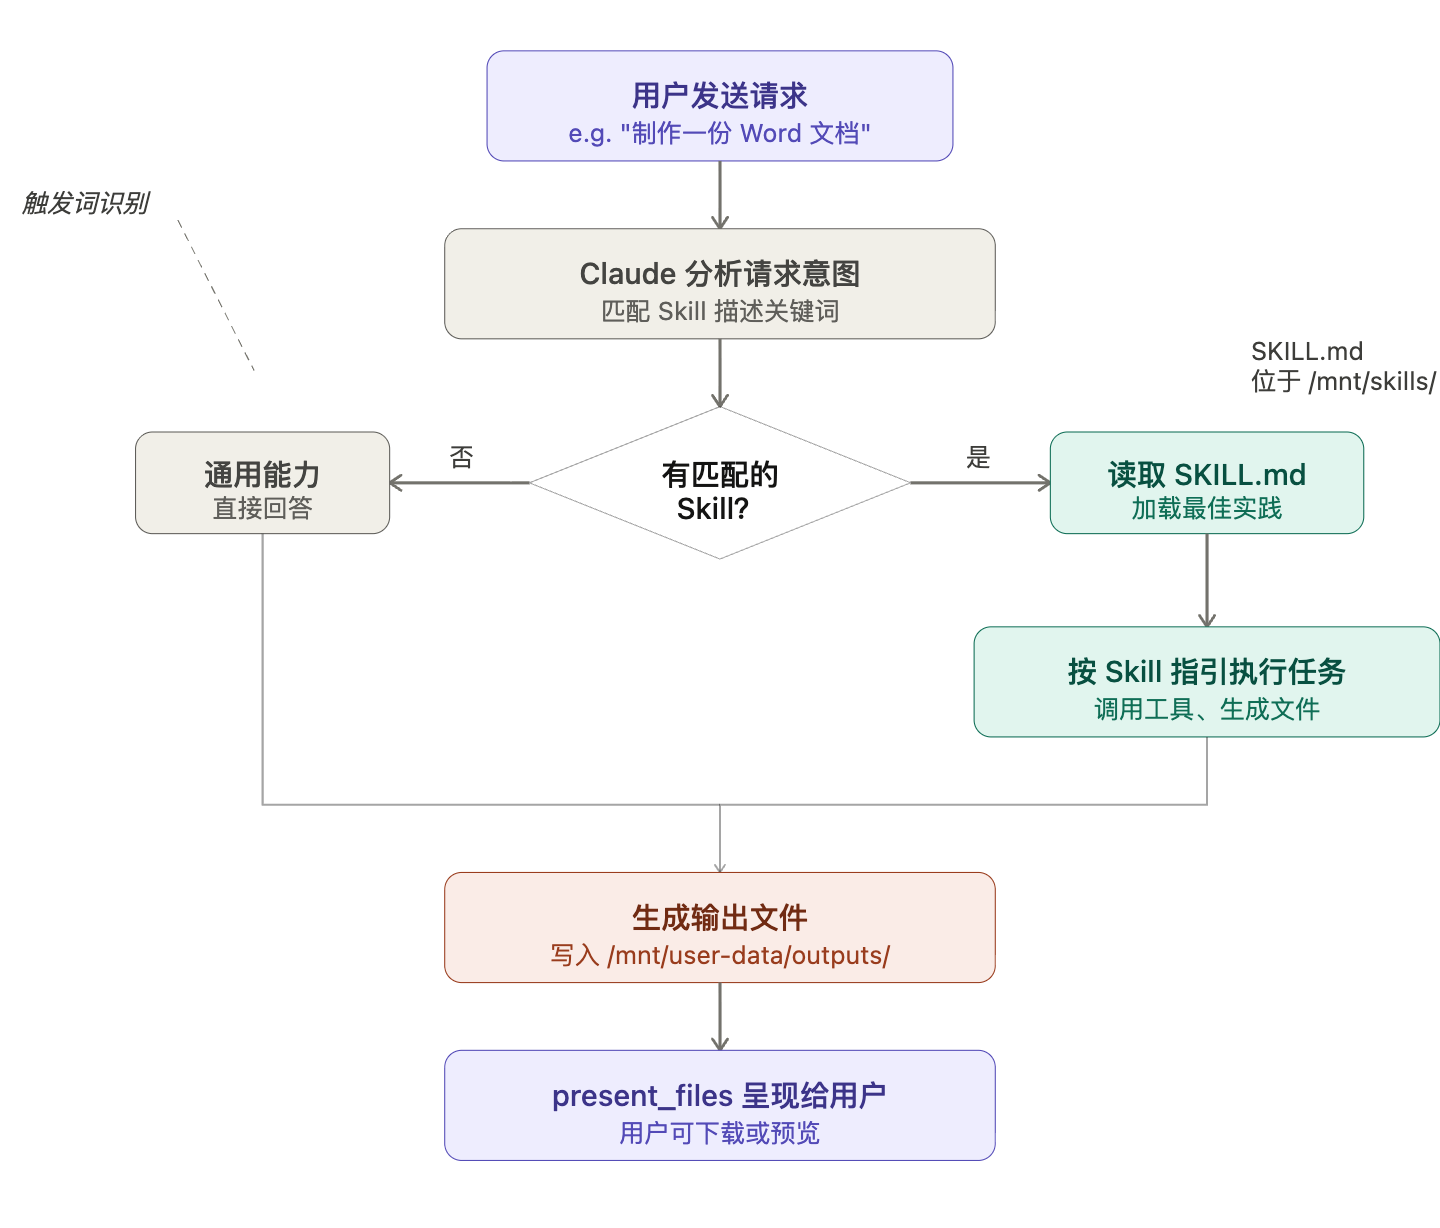
Skill 描述的预算动态为 context window 的 2%,上限 16000 字符。装了太多 skill 时,部分 skill 的 description 可能加载不进来。除此之外,description 有 1024 字符限制,不能把所有变体都塞进去。应选择高频且有区分度的短语。SKILL.md 作为实际传输的部分,遵循 Anthropic 规范,最多不超过 500 行。
多轮推理
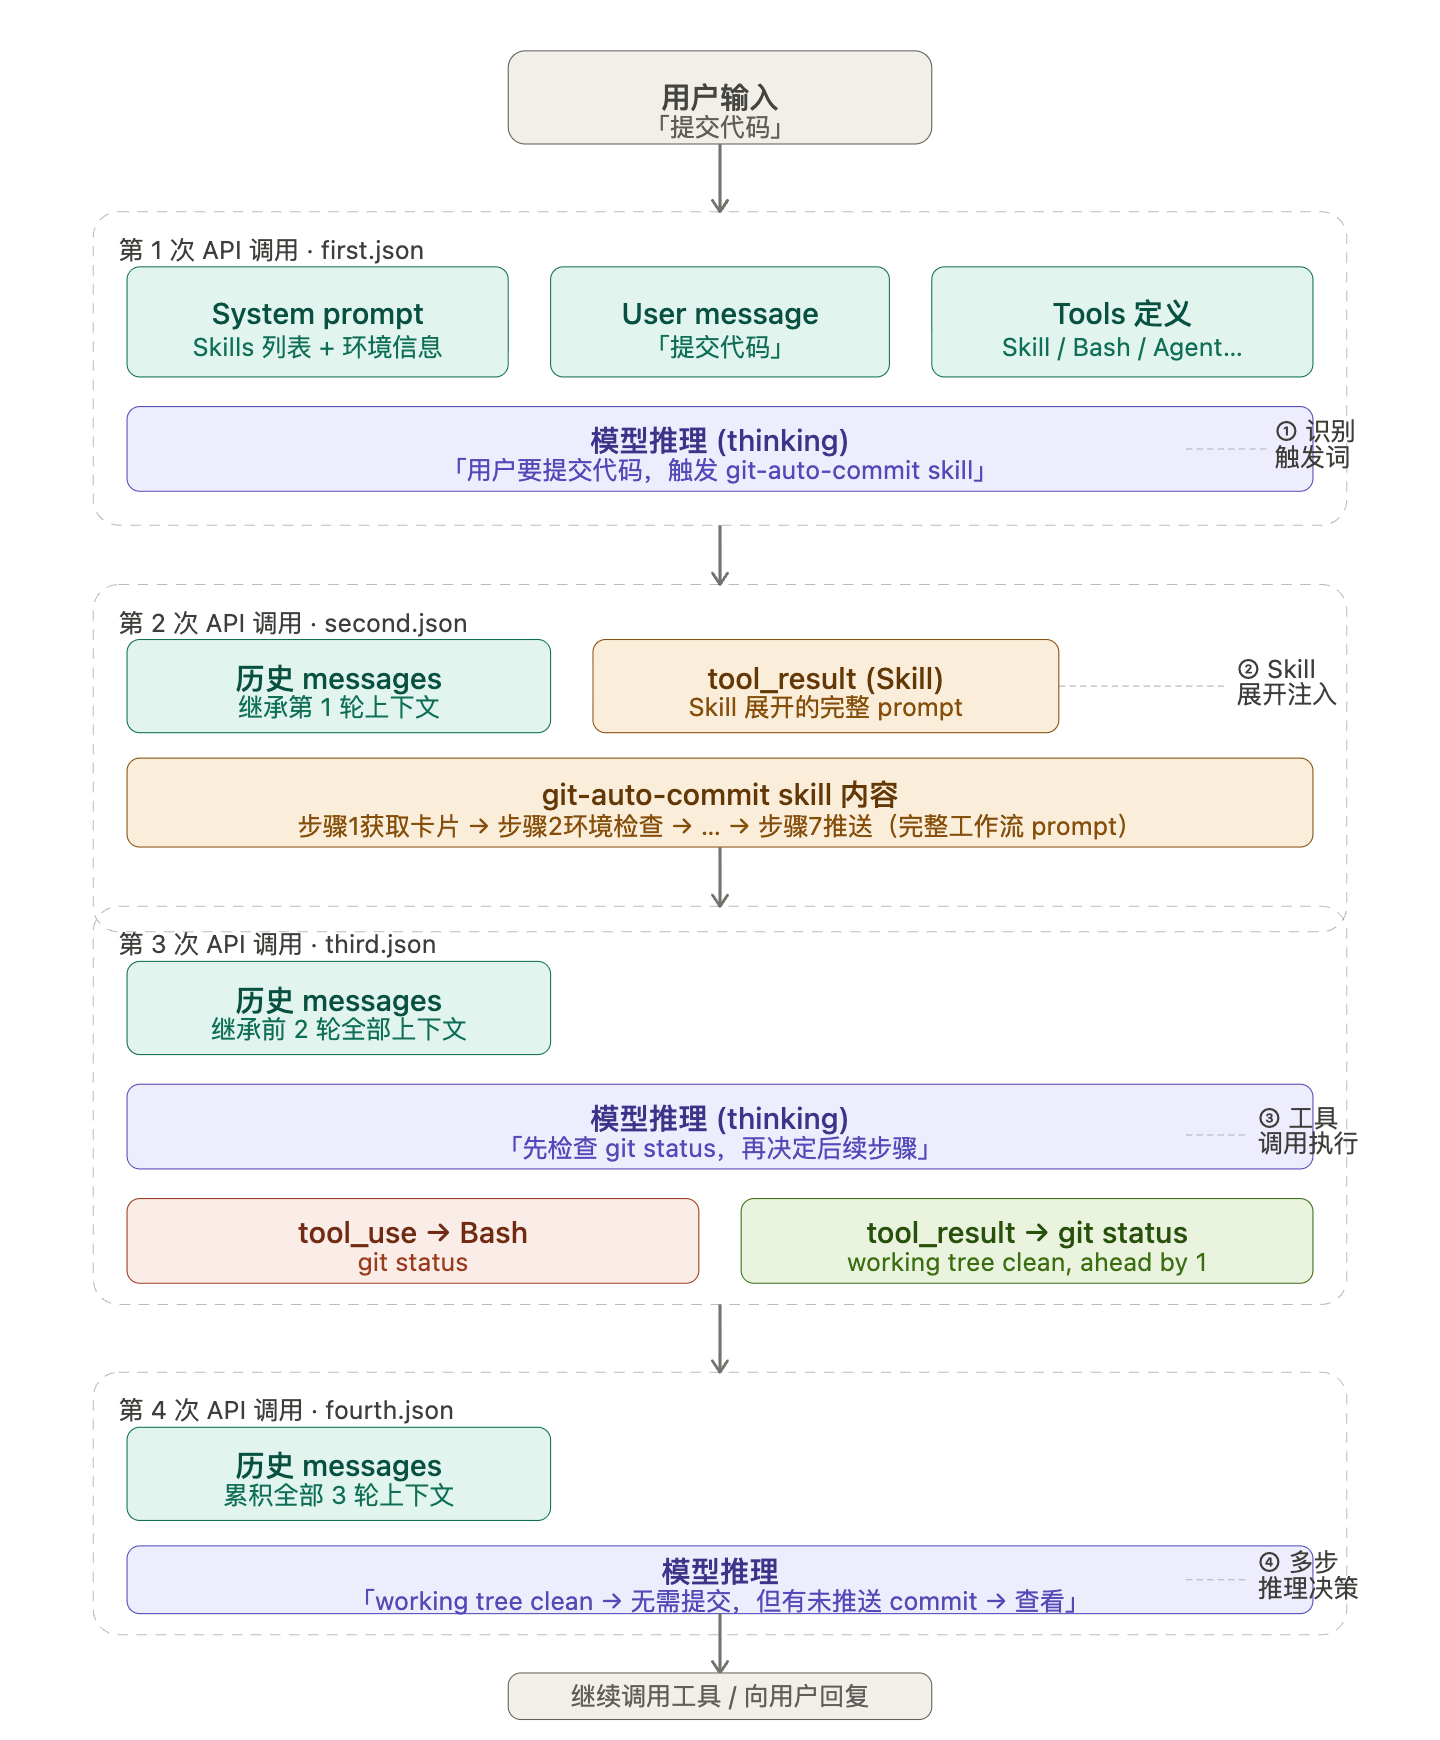
Skills 之所以强大,在于利用了大模型多轮推理使得结果无限趋于正确。
- Skill 本质是一段「延迟注入的 prompt」,在用户触发后才扩展为完整指令
- 每轮上下文累积增长,模型靠完整 messages 历史保持执行状态
thinking字段体现了模型在 Skill 约束下的逐步规划推理过程
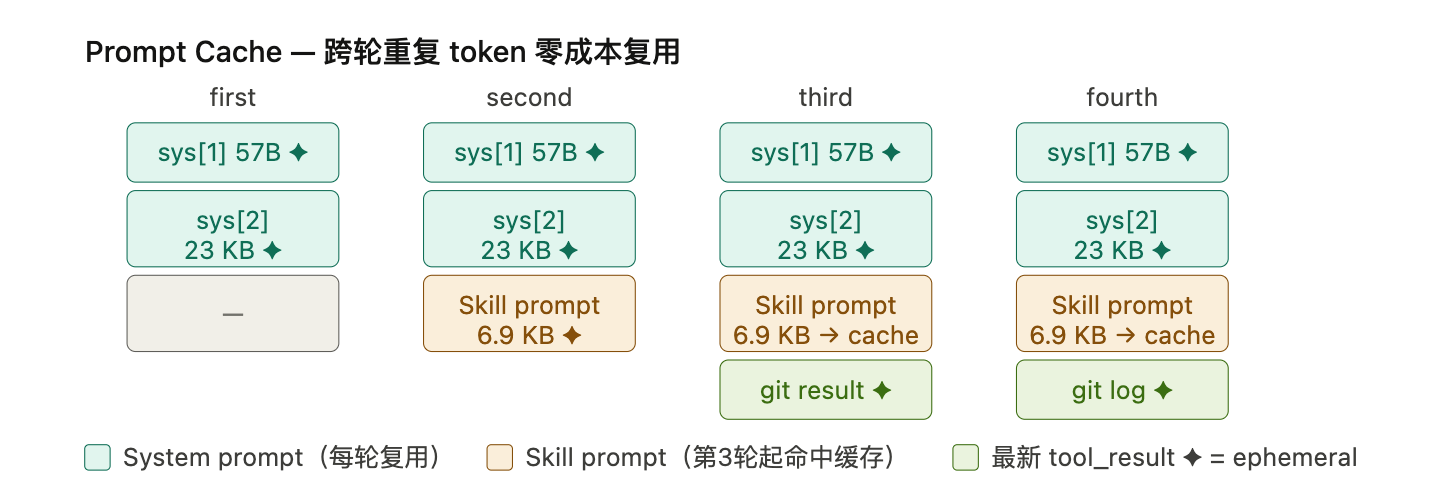
举一个提交代码的例子,先输入提示词“提交代码”,触发 skill 调用。一次 Prompt 输入,会触发 4 次模型调用。因为 json 文件内容较大,我把这 4 个文件都存在了本地。
Skill 的完整执行流程如下图所示:
缓存复用
从用户输入开始,messages 里的 content block 如果带有如下标记,那么模型推理时将会复用标记之前的这段 token。缓存的 token 是不会被计费的。
"cache_control": { "type": "ephemeral" }这是 Anthropic 的 Prompt Caching 特性,每一轮只有最后一个带 cache_control: ephemeral 的块才是真正的缓存断点。 Anthropic 的 Prompt Cache 机制要求缓存是“前缀匹配”的——从 messages 开头连续往后,命中到标记的那个位置为止,这一段前缀被缓存。
Skills 基准测试
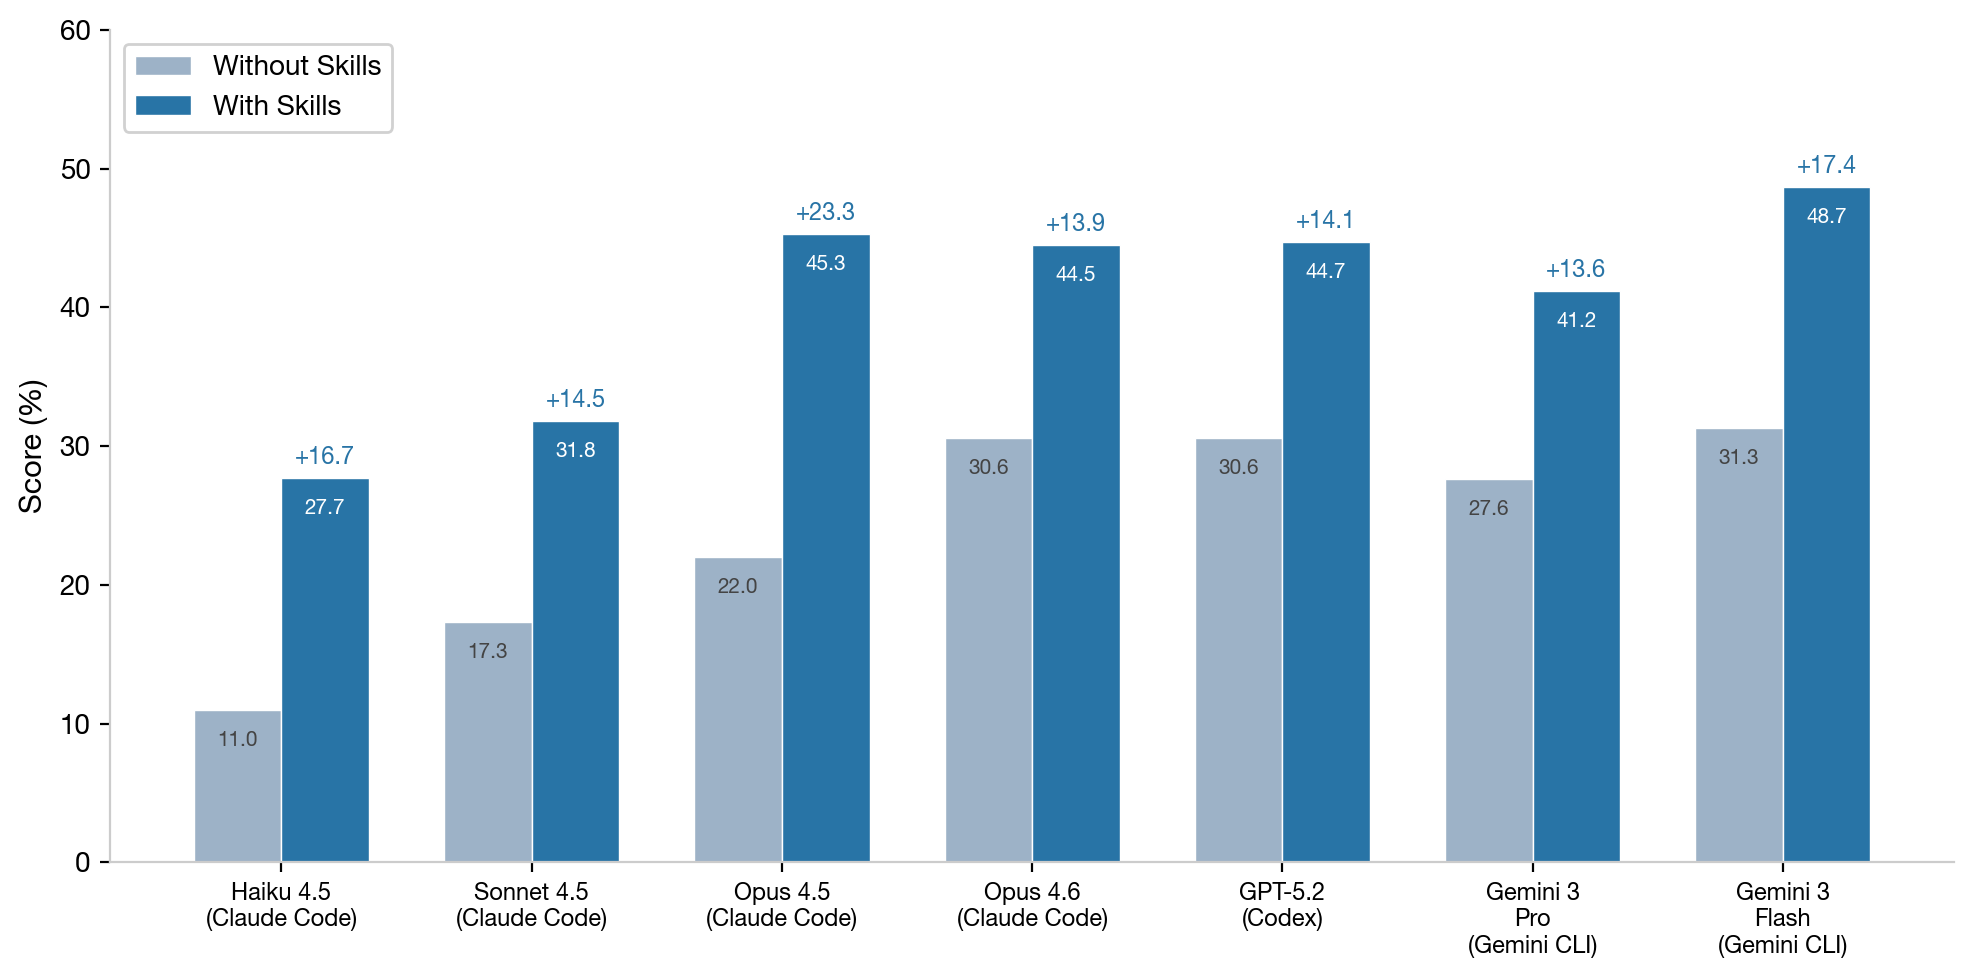
下面这张图是 SkillsBench 通过 86 个任务、11 个领域、7 种模型配置,对照测试“有 Skill vs 没有 Skill”的结果,论文参见 https://www.skillsbench.ai/blogs/introducing-skillsbench。
核心发现
Skill 平均带来 16 个百分点的提升,但差异极大。其中 Claude Code + Opus 4.5 增益最高(+23.3pp),论文认为原因正是 Claude Code 对 Agent Skills 规范做了原生集成——和前面分析的那套 Skill tool / tool_result 展开机制直接对应。
少即是多
2-3 个 Skill 的效果(+20pp)远好于 4 个以上(+5.2pp)。精简的 Skill 比全面的文档效果好近 4 倍。所以 Skill 的写法应该是:约束和禁止项前置,步骤细节放中间,最后用一个质量检查清单收尾——正好利用 U 型曲线的两端。
💡 实际使用中肯定不可能约束 Skills 到 2~3 个,像 Claude Code 自己就集成了不少 Skills,再加上用户自己开发的 Skills,那就更多了。这就变成了玩卡游戏,怎么发挥最大作用完全取决于 Skills 组合。
模型自己生成的 Skill 几乎没用
让模型在解题前先写 Skill 再用,效果接近没有 Skill 的 baseline。原因是模型要么写出“用 pandas 处理数据”这种没有具体 API pattern 的空话,要么根本意识不到自己需要领域知识。人工编写的 Skill 是不可替代的。
Skill 可以替代模型规模
Haiku 4.5 + Skill(27.7%)明显超过 Opus 4.5 无 Skill(22.0%)。便宜的小模型配上好的 Skill,能打赢贵的大模型。
Skill 不总是有益的
84 个任务里有 16 个出现负效果,taxonomy-tree-merge 甚至跌了 39.3pp。软件工程和数学这类模型预训练已经覆盖很好的领域,Skill 加成很小;医疗和制造业这类专有流程领域收益巨大。